In dit project voer je een volledige exploratieve data-analyse uit op de Titanic-dataset — van het laden van de data tot het formuleren van betekenisvolle inzichten.
Je past alle technieken toe die je in de vorige notebooks leerde:
Laden en inspecteren
Ontbrekende waarden analyseren
Opschonen
Univariate analyse (distributies, uitschieters)
Bivariate en multivariate analyse (correlaties, relaties met de doelvariabele)
Inzichten samenvatten
⚠️ Dit is puur exploratief — geen modellen, geen training. Het doel is om de data te begrijpen.
Doelvariabele: survived (0 = niet overleefd, 1 = overleefd)
Onderzoeksvraag: Welke kenmerken hangen samen met de kans op overleven van de ramp?
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import plotly.express as px
import seaborn as sns

sns.set_theme(style="whitegrid", palette="muted")

df_raw = sns.load_dataset("titanic")
print(f"Dataset: {df_raw.shape[0]} rows × {df_raw.shape[1]} columns")
df_raw.head()
Dataset: 891 rows × 15 columns
1. Eerste verkenning
df_raw.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 15 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 survived 891 non-null int64
1 pclass 891 non-null int64
2 sex 891 non-null object
3 age 714 non-null float64
4 sibsp 891 non-null int64
5 parch 891 non-null int64
6 fare 891 non-null float64
7 embarked 889 non-null object
8 class 891 non-null category
9 who 891 non-null object
10 adult_male 891 non-null bool
11 deck 203 non-null category
12 embark_town 889 non-null object
13 alive 891 non-null object
14 alone 891 non-null bool
dtypes: bool(2), category(2), float64(2), int64(4), object(5)
memory usage: 80.7+ KB
df_raw.describe().T.round(2)2. Ontbrekende waarden
missing = pd.DataFrame(
    {
        "n_missing": df_raw.isnull().sum(),
        "pct_missing": (df_raw.isnull().mean() * 100).round(1),
    }
)
missing[missing["n_missing"] > 0].sort_values("pct_missing", ascending=False)fig, ax = plt.subplots(figsize=(10, 3))
sns.heatmap(df_raw.isnull().T, cbar=False, cmap="viridis", ax=ax)
ax.set_title("Missing values (yellow = NaN)")
plt.tight_layout()
plt.show()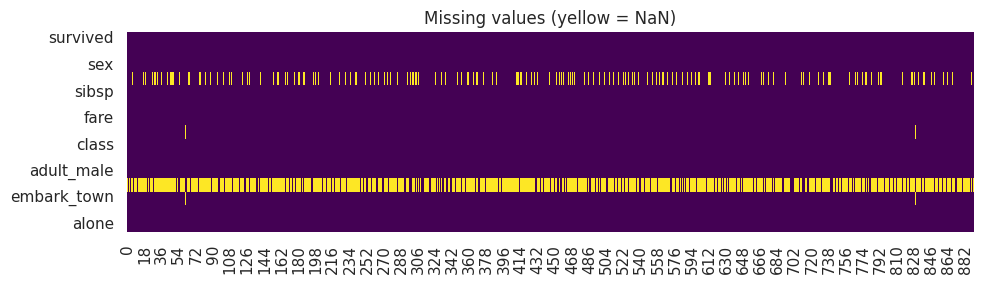
Bevinding:
De kolom
deckheeft meer dan 77% ontbrekende waarden en is niet bruikbaar voor analyse.ageheeft ~20% missende waarden en wordt opgevuld met de mediaan.embarkedheeft slechts 2 missende waarden.
3. Opschonen
df = df_raw.copy()

# Drop columns with > 50% NaN or redundant columns
df = df.drop(columns=["deck", "embark_town", "alive", "who", "adult_male"])

# Fill age with median
df["age"] = df["age"].fillna(df["age"].median())

# Fill embarked with mode
df["embarked"] = df["embarked"].fillna(df["embarked"].mode()[0])

# Cast passenger class to category
df["pclass"] = df["pclass"].astype("category")

print("Missing values after cleaning:")
print(df.isnull().sum())
print(f"\nShape: {df.shape}")
Missing values after cleaning:
survived 0
pclass 0
sex 0
age 0
sibsp 0
parch 0
fare 0
embarked 0
class 0
alone 0
dtype: int64
Shape: (891, 10)
4. Univariate analyse
4a. Doelvariabele: survived
survival_rate = df["survived"].value_counts(normalize=True).round(3) * 100

fig, ax = plt.subplots(figsize=(5, 4))
ax.bar(
    ["Not survived", "Survived"],
    survival_rate.values,
    color=["#e74c3c", "#2ecc71"],
    edgecolor="white",
)
for i, v in enumerate(survival_rate.values):
    ax.text(i, v + 1, f"{v:.1f}%", ha="center", fontsize=12)
ax.set_ylim(0, 100)
ax.set_title("Class balance: survival")
ax.set_ylabel("Percentage")
plt.tight_layout()
plt.show()

print(f"Survival rate: {survival_rate[1]:.1f}%")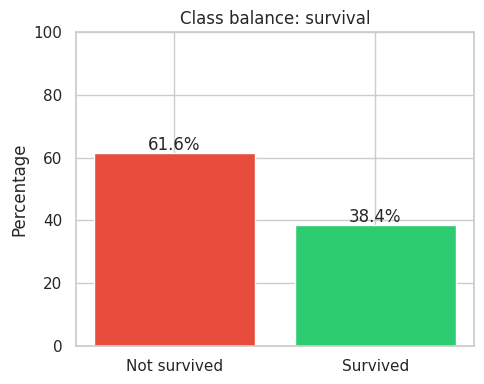
Survival rate: 38.4%
4b. Numerieke variabelen
numeric_columns = ["age", "fare", "sibsp", "parch"]

fig, axes = plt.subplots(2, 2, figsize=(11, 7))
axes = axes.flatten()

for ax, column in zip(axes, numeric_columns):
    data = df[column].dropna()
    sns.histplot(data, bins=25, kde=True, ax=ax, color="steelblue")
    ax.axvline(
        data.mean(), color="red", linestyle="--", alpha=0.8, label=f"mean: {data.mean():.1f}"
    )
    ax.set_title(f"Distribution of {column}")
    ax.legend(fontsize=9)

plt.suptitle("Distributions of numeric variables", fontsize=13)
plt.tight_layout()
plt.show()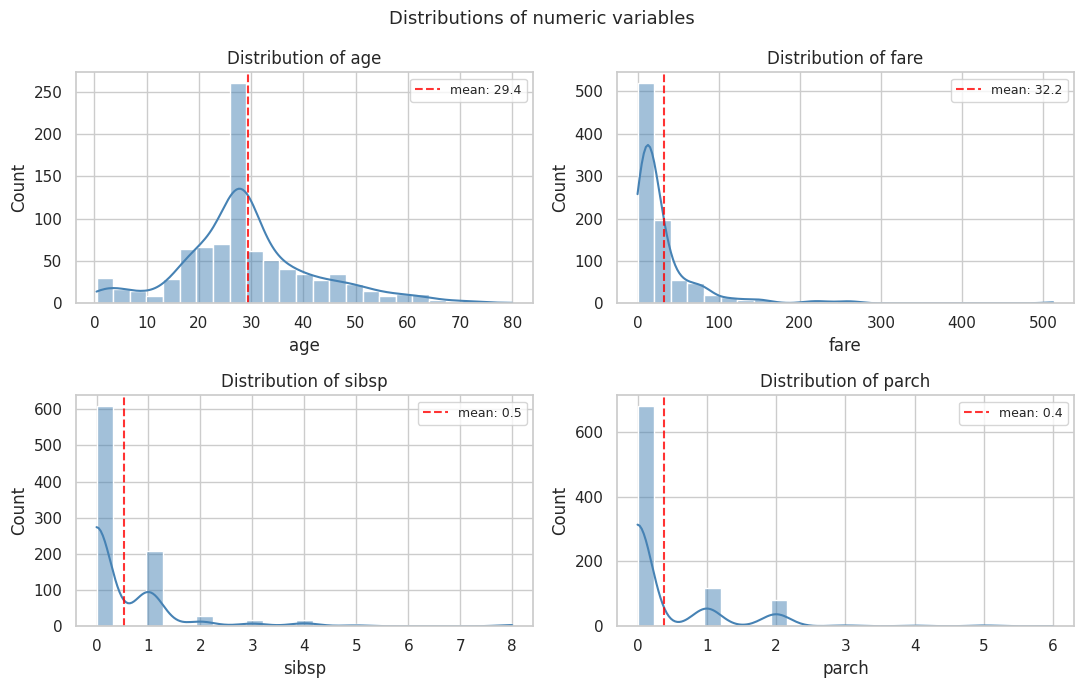
4c. Categorische variabelen
cat_columns = ["pclass", "sex", "embarked"]

fig, axes = plt.subplots(1, 3, figsize=(13, 4))

for ax, column in zip(axes, cat_columns):
    counts = df[column].value_counts()
    ax.bar(counts.index.astype(str), counts.values, color="steelblue", edgecolor="white")
    ax.set_title(f"Distribution of '{column}'")
    ax.set_ylabel("Count")
    for i, v in enumerate(counts.values):
        ax.text(i, v + 3, str(v), ha="center", fontsize=10)

plt.tight_layout()
plt.show()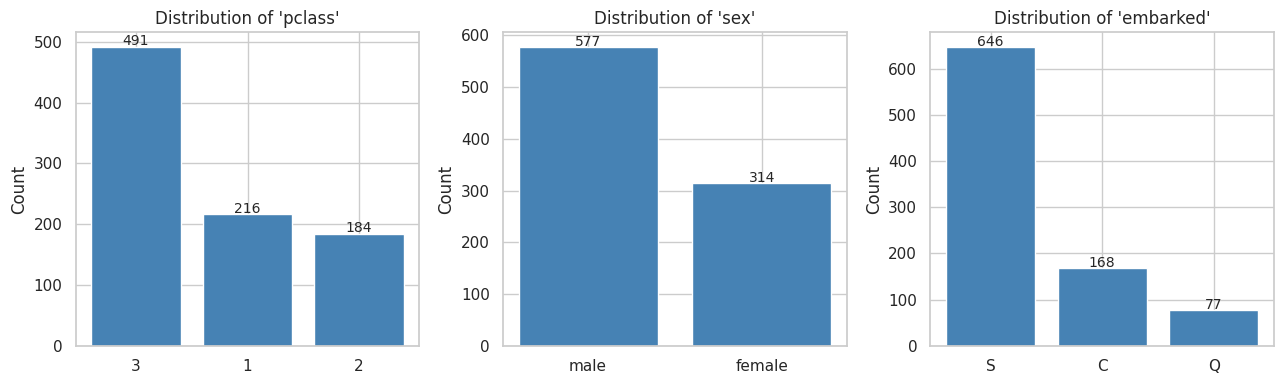
5. Bivariate analyse — relaties met survived
5a. Correlatiematrix
corr = df.select_dtypes(include="number").corr().round(2)

fig, ax = plt.subplots(figsize=(6, 5))
mask = np.triu(np.ones_like(corr, dtype=bool))
sns.heatmap(corr, mask=mask, annot=True, fmt=".2f", cmap="coolwarm", vmin=-1, vmax=1, ax=ax)
ax.set_title("Correlation matrix")
plt.tight_layout()
plt.show()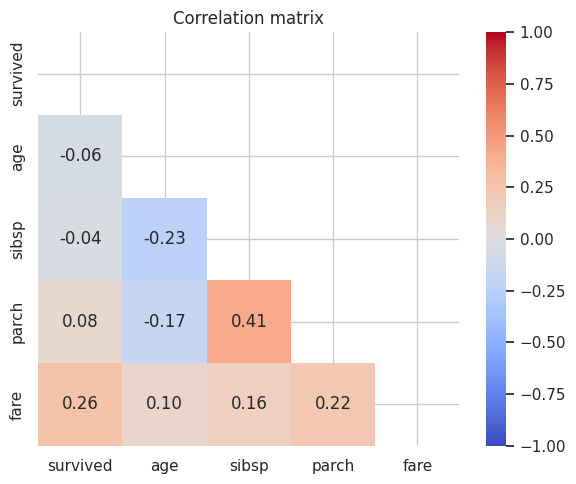
5b. Geslacht en klasse — de sterkste predictoren
fig, axes = plt.subplots(1, 2, figsize=(12, 4))

sns.barplot(data=df, x="sex", y="survived", ax=axes[0])
axes[0].set_title("Survival rate per sex")
axes[0].set_ylabel("Fraction survived")

sns.barplot(data=df, x="pclass", y="survived", hue="sex", ax=axes[1])
axes[1].set_title("Survival by class and sex")
axes[1].set_xlabel("Class")

plt.tight_layout()
plt.show()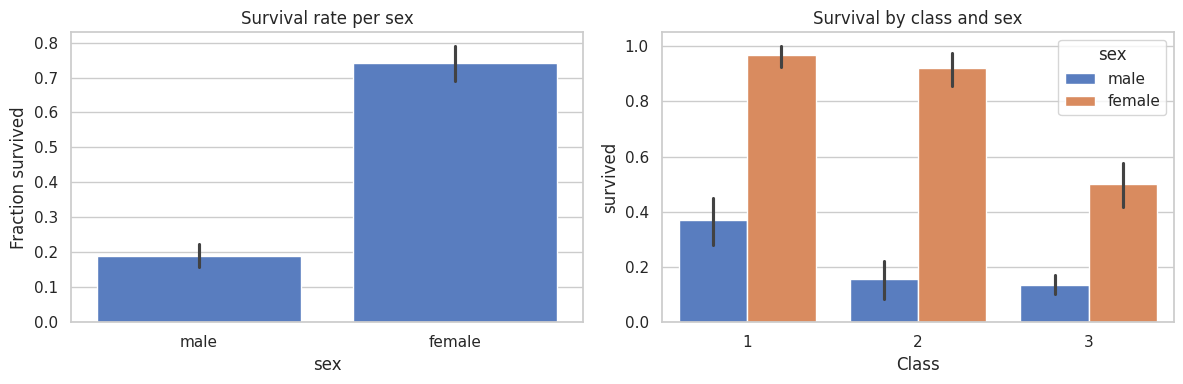
5c. Leeftijdsverdeling per overlevingsstatus
fig = px.histogram(
    df,
    x="age",
    color=df["survived"].map({0: "Not survived", 1: "Survived"}),
    nbins=30,
    barmode="overlay",
    opacity=0.7,
    title="Age distribution per survival status",
    labels={"age": "Age (years)", "count": "Count", "color": "Status"},
    color_discrete_map={"Not survived": "#e74c3c", "Survived": "#2ecc71"},
)
fig.show()5d. Ticketprijs per klasse
fig = px.box(
    df,
    x="pclass",
    y="fare",
    color=df["survived"].map({0: "Not survived", 1: "Survived"}),
    points="outliers",
    title="Ticket prices per class and survival status",
    labels={"pclass": "Class", "fare": "Price (£)", "color": "Status"},
    color_discrete_map={"Not survived": "#e74c3c", "Survived": "#2ecc71"},
)
fig.show()5e. Pairplot
subset = df[["survived", "age", "fare", "sibsp", "parch"]].copy()
subset["survived"] = subset["survived"].map({0: "no", 1: "yes"})

g = sns.pairplot(
    subset,
    hue="survived",
    plot_kws={"alpha": 0.4, "s": 15},
    palette={"no": "#e74c3c", "yes": "#2ecc71"},
)
g.fig.suptitle("Pairplot — survived?", y=1.01)
plt.show()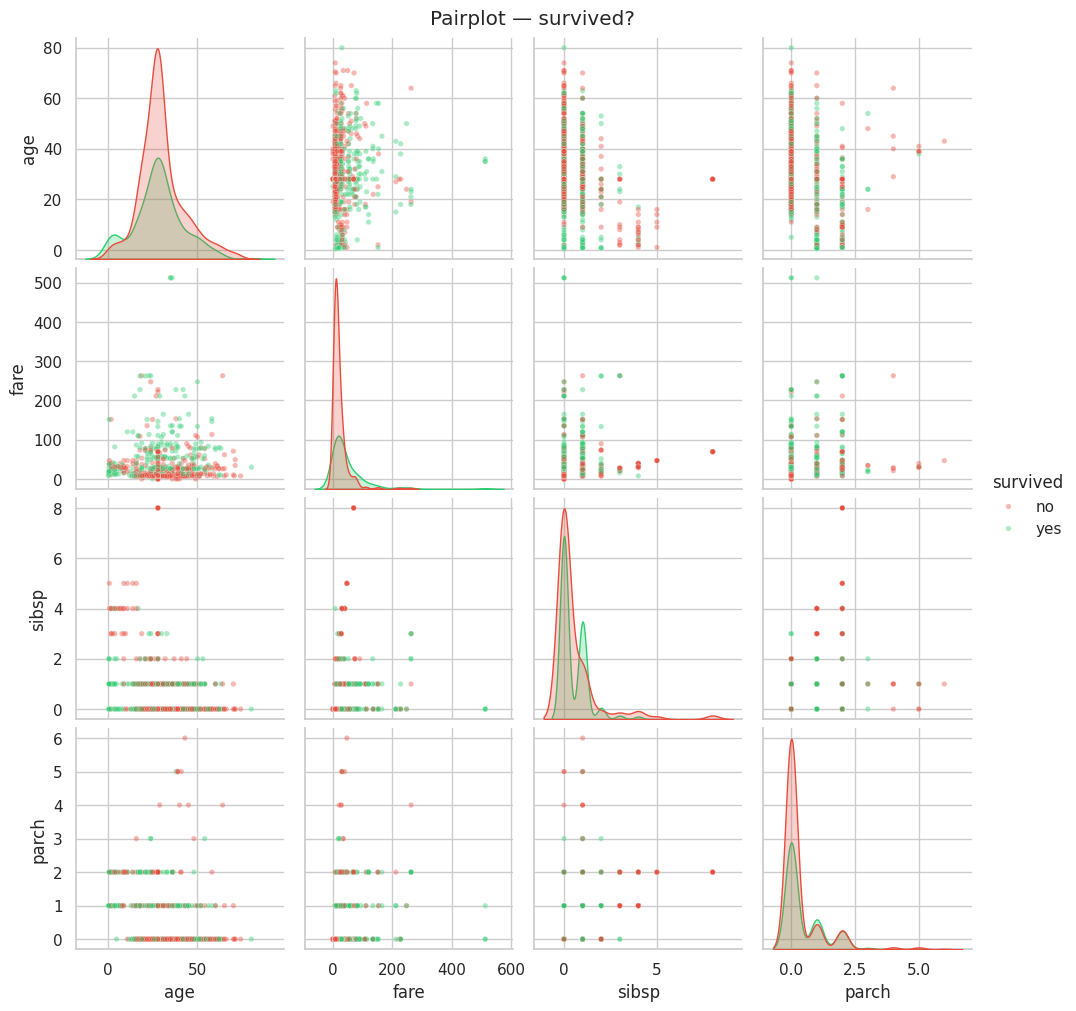
6. Samenvatting van bevindingen
Vul hieronder de bevindingen in op basis van je analyse.
Dataset
De dataset bevat 891 passagiers met 8 relevante kenmerken na opkuisen.
38,4% van de passagiers overleefde de ramp — de dataset is onevenwichtig.
Ontbrekende waarden
deck: 77% NaN → verwijderdage: 20% NaN → opgevuld met mediaan (28 jaar)embarked: 2 NaN → opgevuld met modus
Belangrijkste bevindingen
| Bevinding | Visualisatie |
|---|---|
| Geslacht is de sterkste predictor: vrouwen overleefden in ~74% van de gevallen, mannen slechts in ~19% | Barplot sex vs. survived |
| Klasse heeft een sterk effect: passagiers in eerste klas overleefden veel vaker | Barplot class vs. survived |
| Leeftijd: kinderen (< 10 jaar) hadden een hogere overlevingskans | Histogram per status |
| Ticketprijs correleert positief met overleven — hogere prijs = hogere kans | Boxplot fare |
sibsp en parch (familieleden) tonen een zwakke negatieve correlatie met overleven bij grote aantallen | Pairplot / correlatiematrix |
Volgende stap
De dataset is nu klaar voor verdere analyse in de ML-notebooks.
Oefeningen
Herhaal de bovenstaande analyse voor de Penguins-dataset (sns.load_dataset("penguins")). Gebruik de structuur hierboven als template:
Laden en inspecteren
Ontbrekende waarden analyseren
Opkuisen
Univariate analyse (distributies, categorische verdeling)
Bivariate analyse (correlatieheatmap, relaties met
species)Samenvatting in markdown
Onderzoeksvraag: Welke kenmerken onderscheiden de drie pinguïnsoorten het best?
penguins = sns.load_dataset("penguins")
# Add your EDA in the cells below
# 1. Inspect the dataset# 2. Missing values# 3. Clean# 4. Univariate analysis# 5. Bivariate analysisBevindingen ...